- Published on
Chống duplicate username trong hệ thống 100 triệu users: tại sao chỉ UNIQUE constraint là chưa đủ?
- Authors

- David Nguyen
Table of Contents
- 1. - Tại sao phải quan tâm đến duplicate username?
- 2. - Cách tiếp cận ngây thơ: SELECT trước, INSERT sau
- 2.1 - Vấn đề hiệu năng: full table scan mỗi lần đăng ký
- 2.2 - Vấn đề đúng đắn: race condition khi có nhiều request đồng thời
- 3. - Giải pháp tiêu chuẩn: UNIQUE constraint ở tầng database
- 3.1 - Vì sao index seek lại nhanh: bên trong B+Tree
- 4. - UNIQUE constraint đã đủ chưa? Câu chuyện ở quy mô cực lớn
- 4.1 - Check-then-insert vẫn "race", dù có UNIQUE constraint
- 4.2 - Insert-and-catch: để INSERT tự làm bài kiểm tra
- 4.3 - Fast-path với Redis SETNX: giảm tải cho DB ở traffic cực lớn
- 4.4 - Sharded database: UNIQUE constraint theo shard vẫn chưa đủ
- 4.5 - Bloom filter: trả lời "chắc chắn còn trống" ngay trong bộ nhớ, không cần mạng
- 4.6 - Ghép lại: Bloom filter cho "chắc chắn trống", cache cho "chắc chắn đã lấy"
- 5. - So sánh tổng quan các cách tiếp cận
- 6. - Kết luận & tổng kết
1. - Tại sao phải quan tâm đến duplicate username?
Giả sử anh em đang build một hệ thống có chức năng đăng ký tài khoản, và username là thứ user dùng để đăng nhập (thay vì email hay số điện thoại). Nghe thì đơn giản, username chỉ là một cột VARCHAR trong bảng users thôi mà, sao phải làm căng?
Nhưng thử nhìn ra những sản phẩm anh em dùng hàng ngày một chút. Ở Instagram hay GitHub, username chưa bao giờ chỉ là một credential nằm im chờ user gõ vào ô login - nó là một định danh công khai (public identifier), và rất nhiều thứ khác trong hệ thống trỏ thẳng vào nó:
Instagram:
@usernamechính là URL profile công khai của user (instagram.com/username), là thứ người khác gõ để@mention/tag mình trong một comment hay một story, và cũng là cái tên được in trên business card, link-in-bio, hay đọc lên trong một video giới thiệu. Nó là một danh tính con người có thể nhớ, không đơn thuần là một trường auth trong DB.GitHub:
usernamelà URL profile (github.com/username), là thứ xuất hiện trong@mentionở issue/PR để notify đúng người, và còn được nhúng thẳng vào URL/clone path của repo (github.com/username/repo) lẫn tên scoped package trên npm (@username/package). Nói cách khác, nó không chỉ là chi tiết auth - nó là hạ tầng mà những thứ khác (link, mention, package name) phụ thuộc vào.
=> Vì username giữ vai trò "load-bearing" như vậy, thử tưởng tượng nếu hệ thống cho phép hai user cùng đăng ký username là david99:
instagram.com/david99(haygithub.com/david99) giờ là profile của ai trong hai người? Cái link được in sẵn trên card visit, share sẵn trên mạng xã hội, sẽ resolve về đúng ai?- Khi ai đó gõ
@david99để mention trong một comment hay một issue/PR, hệ thống notify cho người nào - hay notify nhầm cho cả hai? - Khi chính user gõ
david99để login, hệ thống querySELECT * FROM users WHERE username = 'david99'thì trả về... 2 dòng. Login thế nào bây giờ? Lấy dòng đầu tiên? Vậy còn dòng thứ hai thì sao, họ không đăng nhập được vào chính tài khoản của mình à?
=> Đây không còn đơn thuần là chuyện "chọn dòng nào trong kết quả SELECT" nữa - nó là một public collision: hai định danh công khai, hai identity mà người khác đang link tới/mention tới, đụng độ vào đúng một chuỗi ký tự. Chưa kể mọi chỗ khác trong hệ thống lỡ dùng username làm khóa để tra cứu (cache key, log, thông báo nội bộ...) cũng trở nên mơ hồ theo, và đội support sẽ là người lãnh đủ, vì đây là kiểu bug rất khó debug ngược lại (data đã bẩn từ lâu, giờ mới phát hiện).
=> Nói cách khác, username phải là một định danh duy nhất (unique identifier) cho user, tương tự như email hay số CMND/CCCD ngoài đời thực. Nếu để nó bị trùng, mình đang phá vỡ chính cái tính chất cơ bản nhất của một identifier: mỗi giá trị chỉ được trỏ về đúng một thực thể.
Ở một hệ thống vài nghìn user, việc này gần như không đáng lo - xác suất trùng thấp, tải thấp, sai thì fix tay cũng được. Nhưng bài viết này mình muốn bàn về bài toán này ở quy mô 100 triệu+ user records với traffic đăng ký đồng thời rất lớn - đây mới là lúc những cách làm "tưởng như hiển nhiên" bắt đầu bộc lộ vấn đề.
2. - Cách tiếp cận ngây thơ: SELECT trước, INSERT sau
Cách làm phổ biến nhất mà hầu như ai mới học backend cũng viết theo phản xạ:
@Service
@RequiredArgsConstructor
public class UserService {

    private final UserRepository userRepository;
    private final PasswordEncoder passwordEncoder;

    // ❌ Cách làm ngây thơ - đừng dùng ở scale lớn
    public User registerNaive(String username, String rawPassword) {
        User existing = userRepository.findByUsername(username);
        if (existing != null) {
            throw new UsernameAlreadyTakenException(username);
        }

        User user = new User();
        user.setUsername(username);
        user.setPasswordHash(passwordEncoder.encode(rawPassword));
        user.setCreatedAt(Instant.now());

        return userRepository.save(user);
    }
}
public interface UserRepository extends JpaRepository<User, Long> {
    User findByUsername(String username);
}
Logic rất trực quan: check trước xem username đã tồn tại chưa, nếu chưa thì mới INSERT. Ở bảng users chưa có index gì đặc biệt trên cột username cả - dù sao thì "cứ chạy được đã, tối ưu tính sau".
Vấn đề là ở quy mô 100 triệu+ dòng, cách làm này sai theo hai hướng hoàn toàn khác nhau.
2.1 - Vấn đề hiệu năng: full table scan mỗi lần đăng ký
findByUsername() phía trên sinh ra câu lệnh:
SELECT * FROM users WHERE username = 'david99';
Nếu cột username không có index, database không còn cách nào khác ngoài full table scan - quét tuần tự (hoặc gần như vậy) qua toàn bộ bảng để tìm dòng khớp điều kiện. Với 100 triệu dòng, mỗi lần đăng ký user mới đều phải trả giá bằng một lượt quét cỡ đó.
=> Ở một hệ thống có hàng chục nghìn lượt đăng ký mỗi ngày, riêng cái check trùng username thôi cũng đủ làm nghẽn cả cluster database, chưa nói đến các query khác đang chạy song song.
Nghe tới đây chắc anh em nghĩ ngay: "thêm index vào là xong chứ gì?" - đúng, nhưng đó là chuyện của phần 3. Cái đáng nói hơn là kể cả khi mình thêm index để giải quyết bài toán hiệu năng, logic "SELECT rồi mới INSERT" vẫn còn một lỗ hổng khác, nguy hiểm hơn nhiều.
2.2 - Vấn đề đúng đắn: race condition khi có nhiều request đồng thời
Đây là kiểu bug kinh điển trong lập trình concurrent gọi là check-then-act race condition: giữa lúc "check" (SELECT) và lúc "act" (INSERT), có một khoảng hở đủ để một request khác chen vào.
Thử hình dung timeline của hai request đăng ký username = "david99" gần như cùng lúc:
- T0: Request A (đăng ký
david99) gửiSELECT * FROM users WHERE username = 'david99'→ chưa có dòng nào → trả về rỗng. - T0 + 1ms: Request B (cũng đăng ký
david99) gửiSELECT * FROM users WHERE username = 'david99'→ vì INSERT của Request A chưa commit, Request B cũng thấy rỗng. - T1: Request A tiếp tục, thực thi
INSERT INTO users(username, ...) VALUES ('david99', ...)và commit thành công. - T1 + 1ms: Request B, vì đã "pass" bước check ở bước 2, cũng thực thi
INSERT INTO users(username, ...) VALUES ('david99', ...)và commit thành công.
=> Kết quả: bảng users có 2 dòng cùng username = 'david99'. Cả hai request đều "làm đúng" theo logic của nó, nhưng vì check và act không phải một thao tác nguyên tử (atomic), race condition vẫn xảy ra "âm thầm" mà không hề có exception nào bắn ra để cảnh báo.
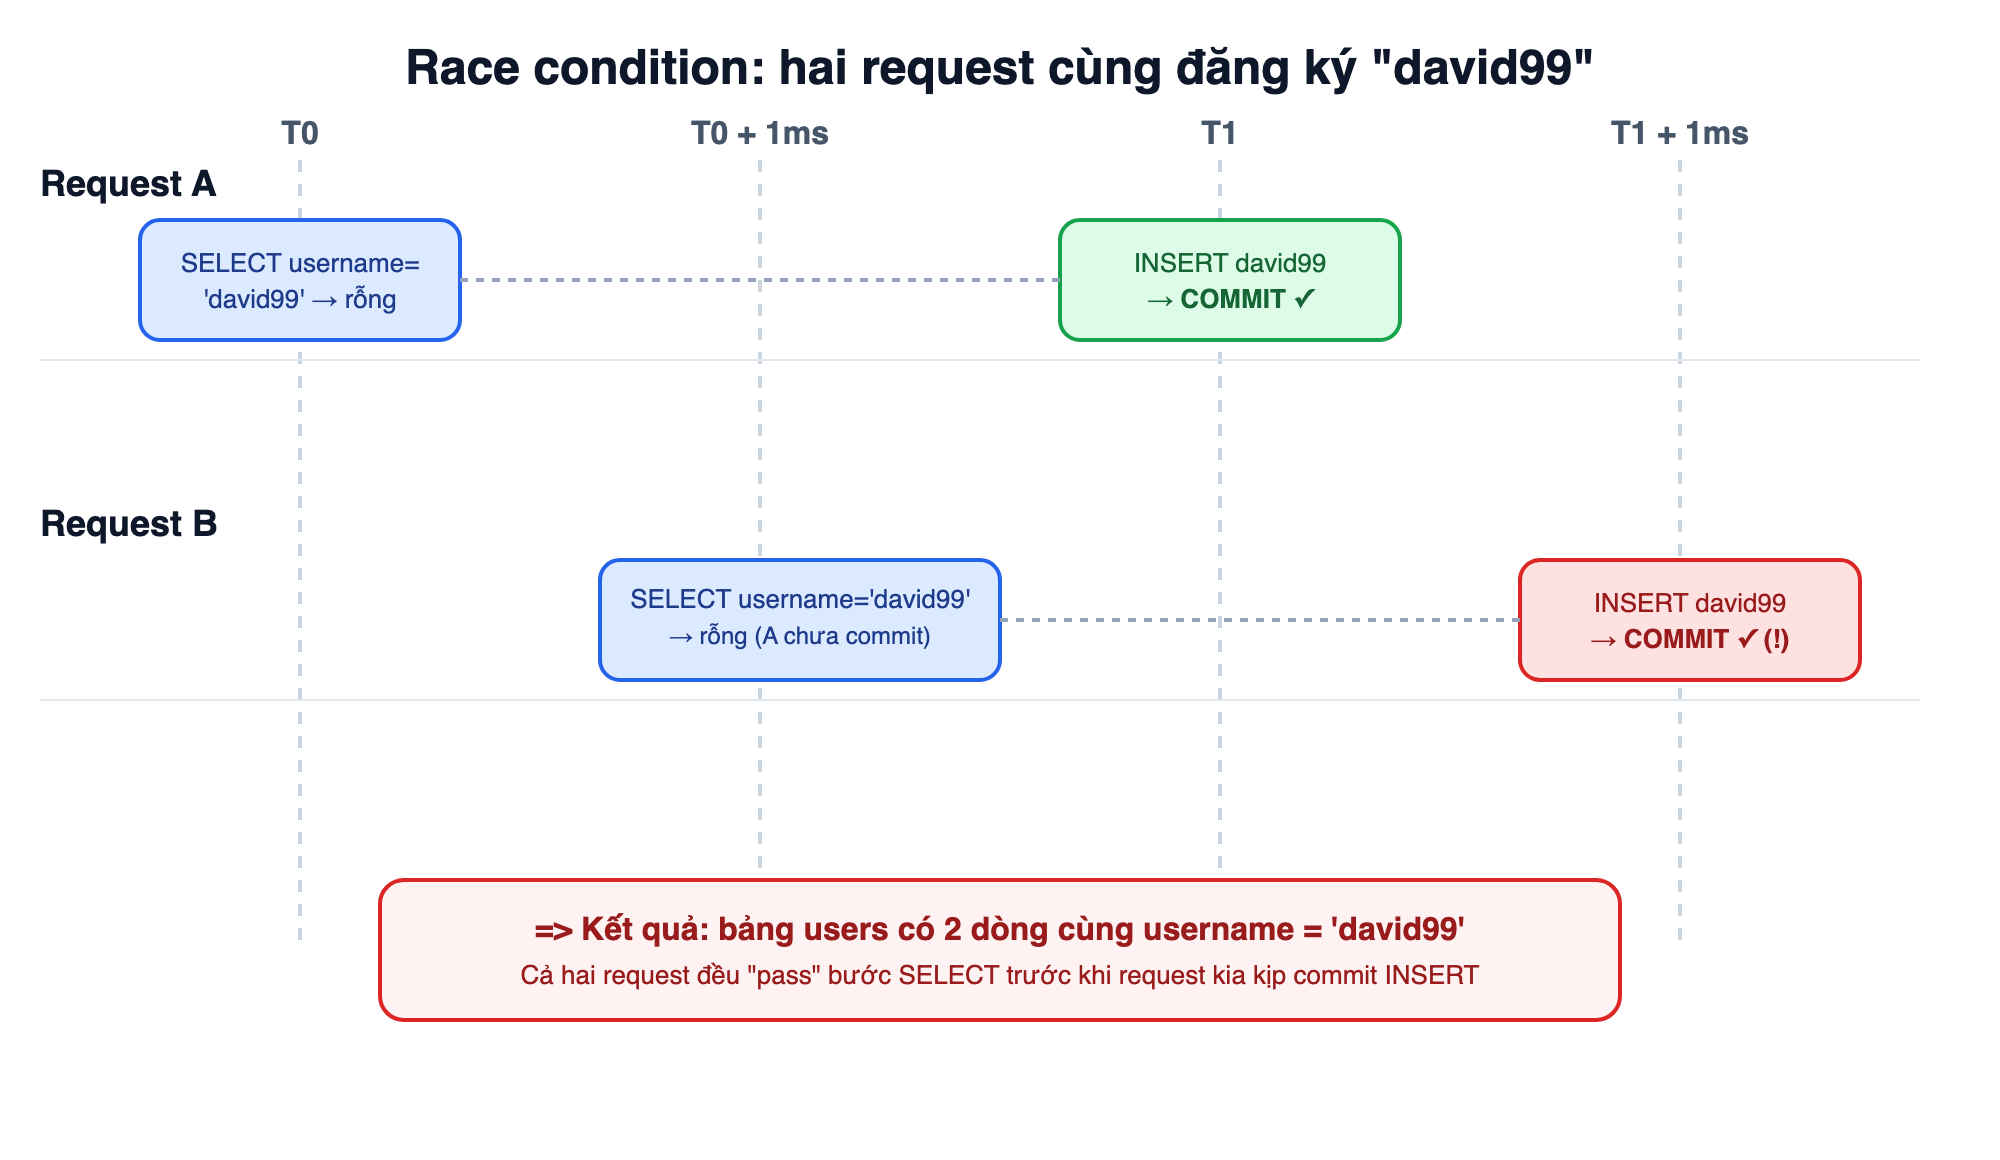
Hai request cùng đăng ký "david99" đan xen nhau: cả hai đều SELECT thấy rỗng trước khi request còn lại kịp commit INSERT
Ở quy mô vài trăm request/ngày thì xác suất hai request cùng username đâm trúng nhau gần như bằng không. Nhưng ở hệ thống 100 triệu+ user với hàng nghìn request đăng ký mỗi giây (nghĩ tới một chiến dịch marketing hot, hoặc một đợt mở đăng ký giới hạn), xác suất này không còn là lý thuyết nữa - nó là chuyện sẽ xảy ra, chỉ là sớm hay muộn.
=> Kết luận 1: Cách check-then-insert ở tầng application vừa chậm (không có index) vừa sai (race condition dưới tải cao) - hai vấn đề độc lập, và giải quyết vấn đề này không tự động giải quyết vấn đề kia.
3. - Giải pháp tiêu chuẩn: UNIQUE constraint ở tầng database
Vậy làm sao để vừa nhanh vừa đúng? Câu trả lời tiêu chuẩn: đừng để application tự phán xét "username này đã tồn tại hay chưa" - hãy để database làm trọng tài, thông qua một UNIQUE constraint (kèm index) trên cột username.
ALTER TABLE users
  ADD CONSTRAINT uk_users_username UNIQUE (username);
Với Postgres, nếu bảng đã có sẵn 100 triệu dòng và anh em không muốn khóa bảng khi tạo index, có thể dùng:
CREATE UNIQUE INDEX CONCURRENTLY IF NOT EXISTS uk_users_username
  ON users (username);
Và khai báo tương ứng trong entity với JPA:
@Entity
@Table(
    name = "users",
    uniqueConstraints = @UniqueConstraint(name = "uk_users_username", columnNames = "username")
)
public class User {

    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    private Long id;

    @Column(name = "username", nullable = false, unique = true, length = 64)
    private String username;

    @Column(name = "password_hash", nullable = false)
    private String passwordHash;

    @Column(name = "created_at", nullable = false, updatable = false)
    private Instant createdAt;
}
UNIQUE constraint mang lại hai lợi ích cùng lúc:
- Đảm bảo đúng đắn (correctness): dù application có bug, có race condition, có bao nhiêu request chen lẫn nhau đi nữa, database vẫn tuyệt đối không cho phép hai dòng có cùng
usernametồn tại. Đây mới là nguồn chân lý (single source of truth) cho tính duy nhất củausername, chứ không phải câuSELECTở tầng application. - Giải quyết luôn bài toán hiệu năng:
UNIQUEconstraint trong hầu hết database (MySQL, Postgres, ...) được backing bởi một index. CâuSELECT ... WHERE username = ?giờ đây là một index seek thay vì full table scan - từ độ phức tạp gầnO(n)xuốngO(log n).
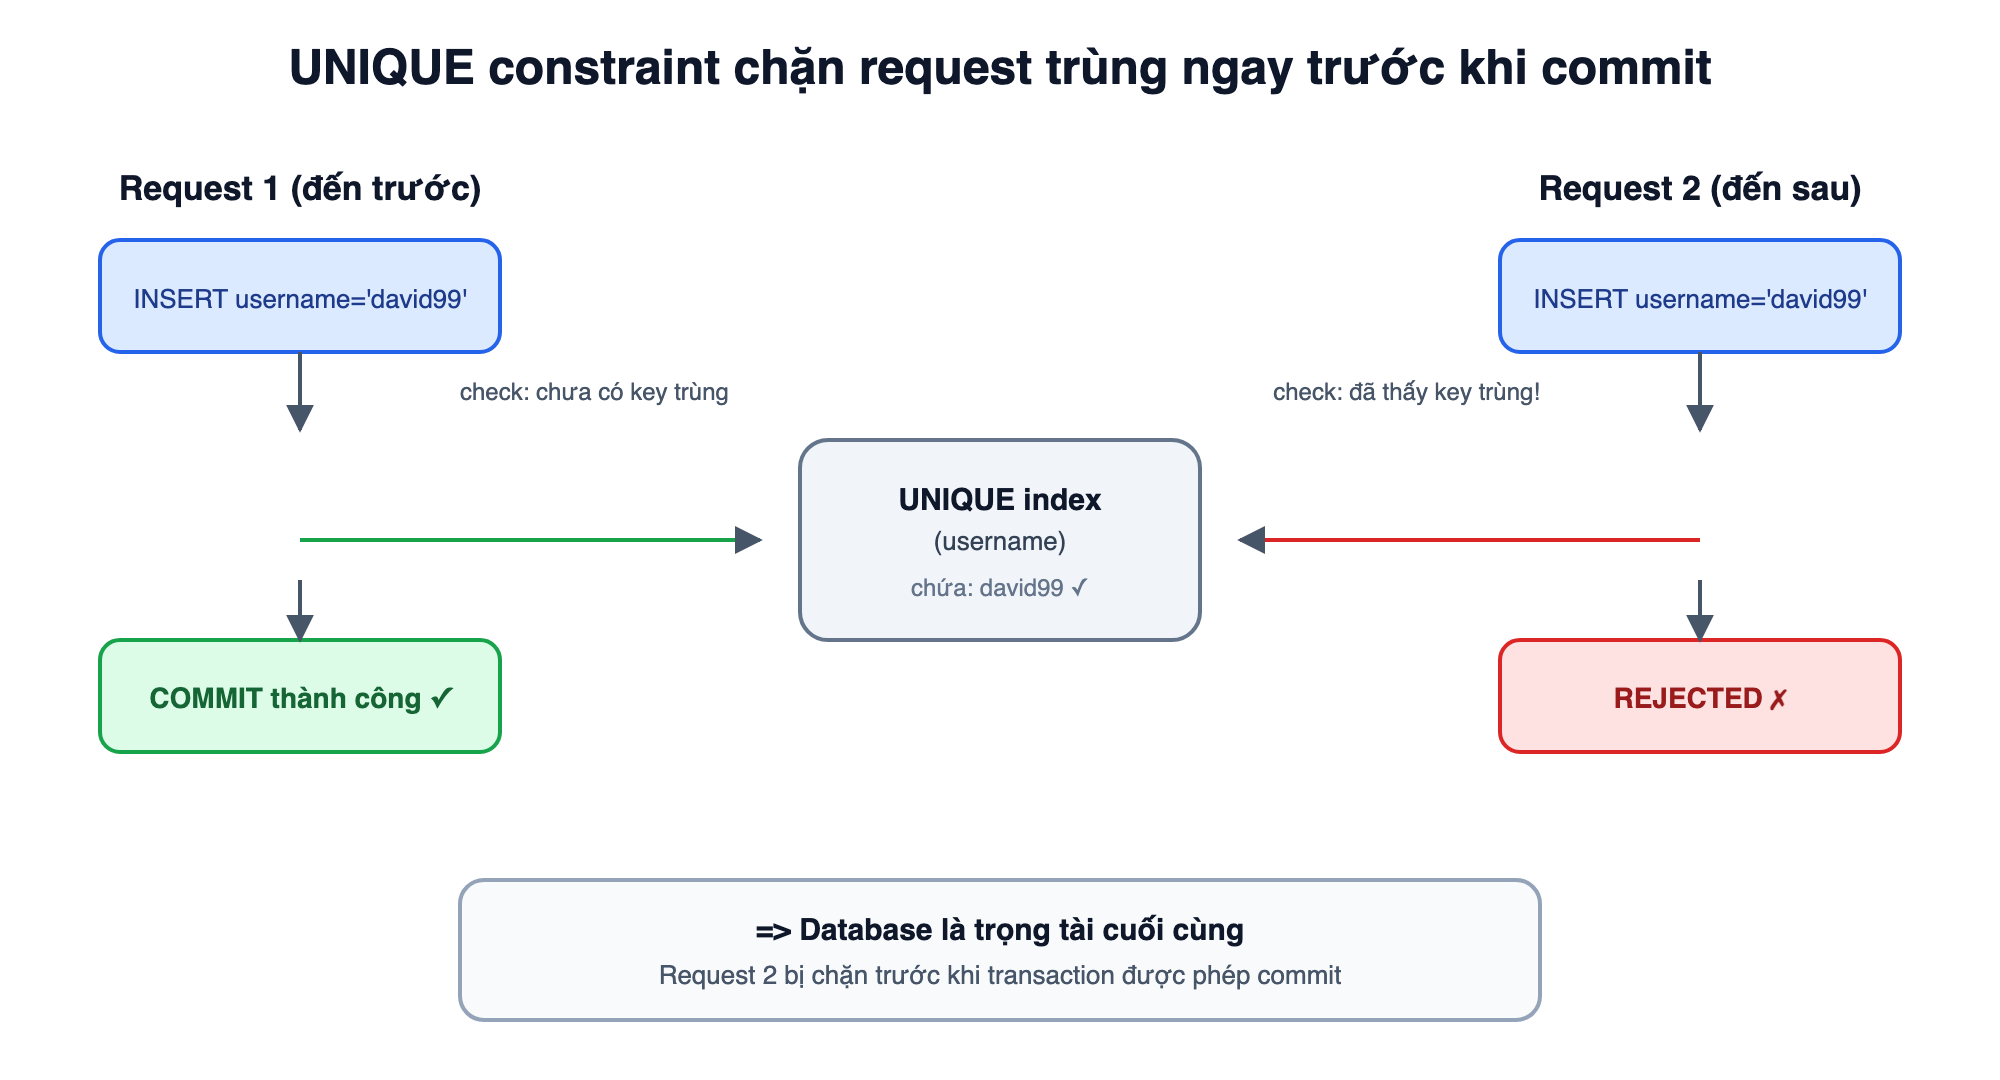
Hai lượt INSERT cùng "david99": lượt đầu đi qua unique index và được ghi thành công, lượt sau bị chính unique index chặn lại trước khi commit
3.1 - Vì sao index seek lại nhanh: bên trong B+Tree
Đến đây chắc anh em chấp nhận luôn câu "có index thì nhanh hơn" như một tiên đề - nhưng khoan, vì sao một index seek lại nhanh hơn full table scan tới mức đổi hẳn độ phức tạp từ O(n) xuống O(log n)? Hiểu rõ cơ chế bên dưới sẽ giúp anh em tự tin hơn khi debug hoặc thiết kế index sau này, thay vì chỉ "tin" vào lời khuyên "cứ thêm index vào".
Cả MySQL (InnoDB) lẫn Postgres đều dùng B+Tree (một biến thể của B-tree) làm cấu trúc dữ liệu mặc định cho index nói chung, và cho index đứng sau UNIQUE constraint nói riêng. Cấu trúc này có vài đặc điểm mấu chốt:
- Đây là một cây cân bằng (balanced tree) - mọi đường đi từ root xuống leaf đều có độ dài bằng nhau, không có nhánh nào "lệch" sâu hơn nhánh khác.
- Các key được lưu có thứ tự (sorted) trong toàn bộ cây, kể cả ở internal node lẫn leaf node.
- Internal node không chứa dữ liệu thật - nó chỉ đóng vai trò như một "bảng chỉ dẫn" (signpost): mỗi entry trong internal node là một khoảng giá trị key, trỏ tới node con phụ trách khoảng đó.
- Leaf node mới là nơi chứa dữ liệu thật (với
InnoDB, đây chính là row data, vì index củaUNIQUEconstraint thường trùng hoặc liên kết trực tiếp với clustered index; với Postgres, leaf node chứa pointer trỏ tới dòng thật trong heap table). Các leaf node còn được nối với nhau thành một danh sách liên kết, giúp việc quét theo khoảng (range scan) hiệu quả.
Giờ thử áp cấu trúc này vào đúng câu query đã nhắc ở phần 2: SELECT * FROM users WHERE username = 'david99'. Một lượt tra cứu sẽ đi qua đúng 3-4 bước:
- Root node: so sánh
'david99'với các khoảng giá trị ở root, xác định nhánh con nào có thể chứa key này, rồi đi xuống. - Internal node (có thể lặp lại 1-2 lần tuỳ độ sâu cây): tiếp tục thu hẹp khoảng giá trị, đi xuống nhánh phù hợp tiếp theo.
- Leaf node: đây là nơi quyết định cuối cùng - nếu tìm thấy key
'david99'khớp chính xác trong leaf này, database trả về row (hoặc pointer tới row) tương ứng; nếu không, database biết chắc'david99'không tồn tại trong bảng, vì tại đúng vị trí đáng lẽ nó phải nằm (dựa trên thứ tự sorted), lại không có.
=> Với 100 triệu+ dòng, vì sao cây này chỉ cao 3-4 tầng thay vì hàng chục/hàng trăm tầng? Vì fan-out (số nhánh con mỗi node có thể trỏ tới) rất cao - một page của B+Tree (thường 8-16KB) có thể chứa hàng trăm entry, nên mỗi tầng cây "nhân" khả năng phân nhánh lên hàng trăm lần. Với fan-out cỡ vài trăm, một cây cao 4 tầng đã đủ sức chứa tới 300^4 ≈ hàng chục tỷ key - thừa sức cho quy mô 100 triệu dòng. Nói cách khác, thay vì phải đọc 100 triệu dòng, database chỉ cần đọc 3-4 page (mà sau vài lượt truy vấn đầu, các page ở gần root gần như luôn nằm sẵn trong buffer pool/cache) để đi từ root tới leaf.
Và đây cũng chính là lý do UNIQUE constraint enforce nhanh, không chỉ riêng SELECT mới hưởng lợi: khi anh em INSERT một dòng mới, database phải thực hiện đúng traversal y hệt ở trên để xác định vị trí leaf node nơi key mới "đáng lẽ" phải nằm - và nếu tại đúng vị trí đó đã có một key trùng khớp, INSERT bị chặn lại trước khi transaction được phép commit. Nhờ traversal chỉ tốn 3-4 page read, việc kiểm tra "key này đã tồn tại chưa" trước khi cho phép ghi cũng nhanh gần như tương đương một lần đọc - đó là lý do UNIQUE constraint không hề làm chậm insert throughput một cách đáng kể, dù nó phải "soi" qua toàn bộ 100 triệu dòng đã có để tìm collision.
Note: Một hash index (nếu database hỗ trợ, ví dụ Postgres có USING hash) về lý thuyết còn nhanh hơn nữa cho lookup bằng chính xác (O(1) trung bình), nhưng đánh đổi là mất khả năng range query (BETWEEN, username > 'd', ORDER BY username, prefix match...) - đó là lý do MySQL và Postgres đều mặc định backing UNIQUE constraint bằng B+Tree thay vì hash index.
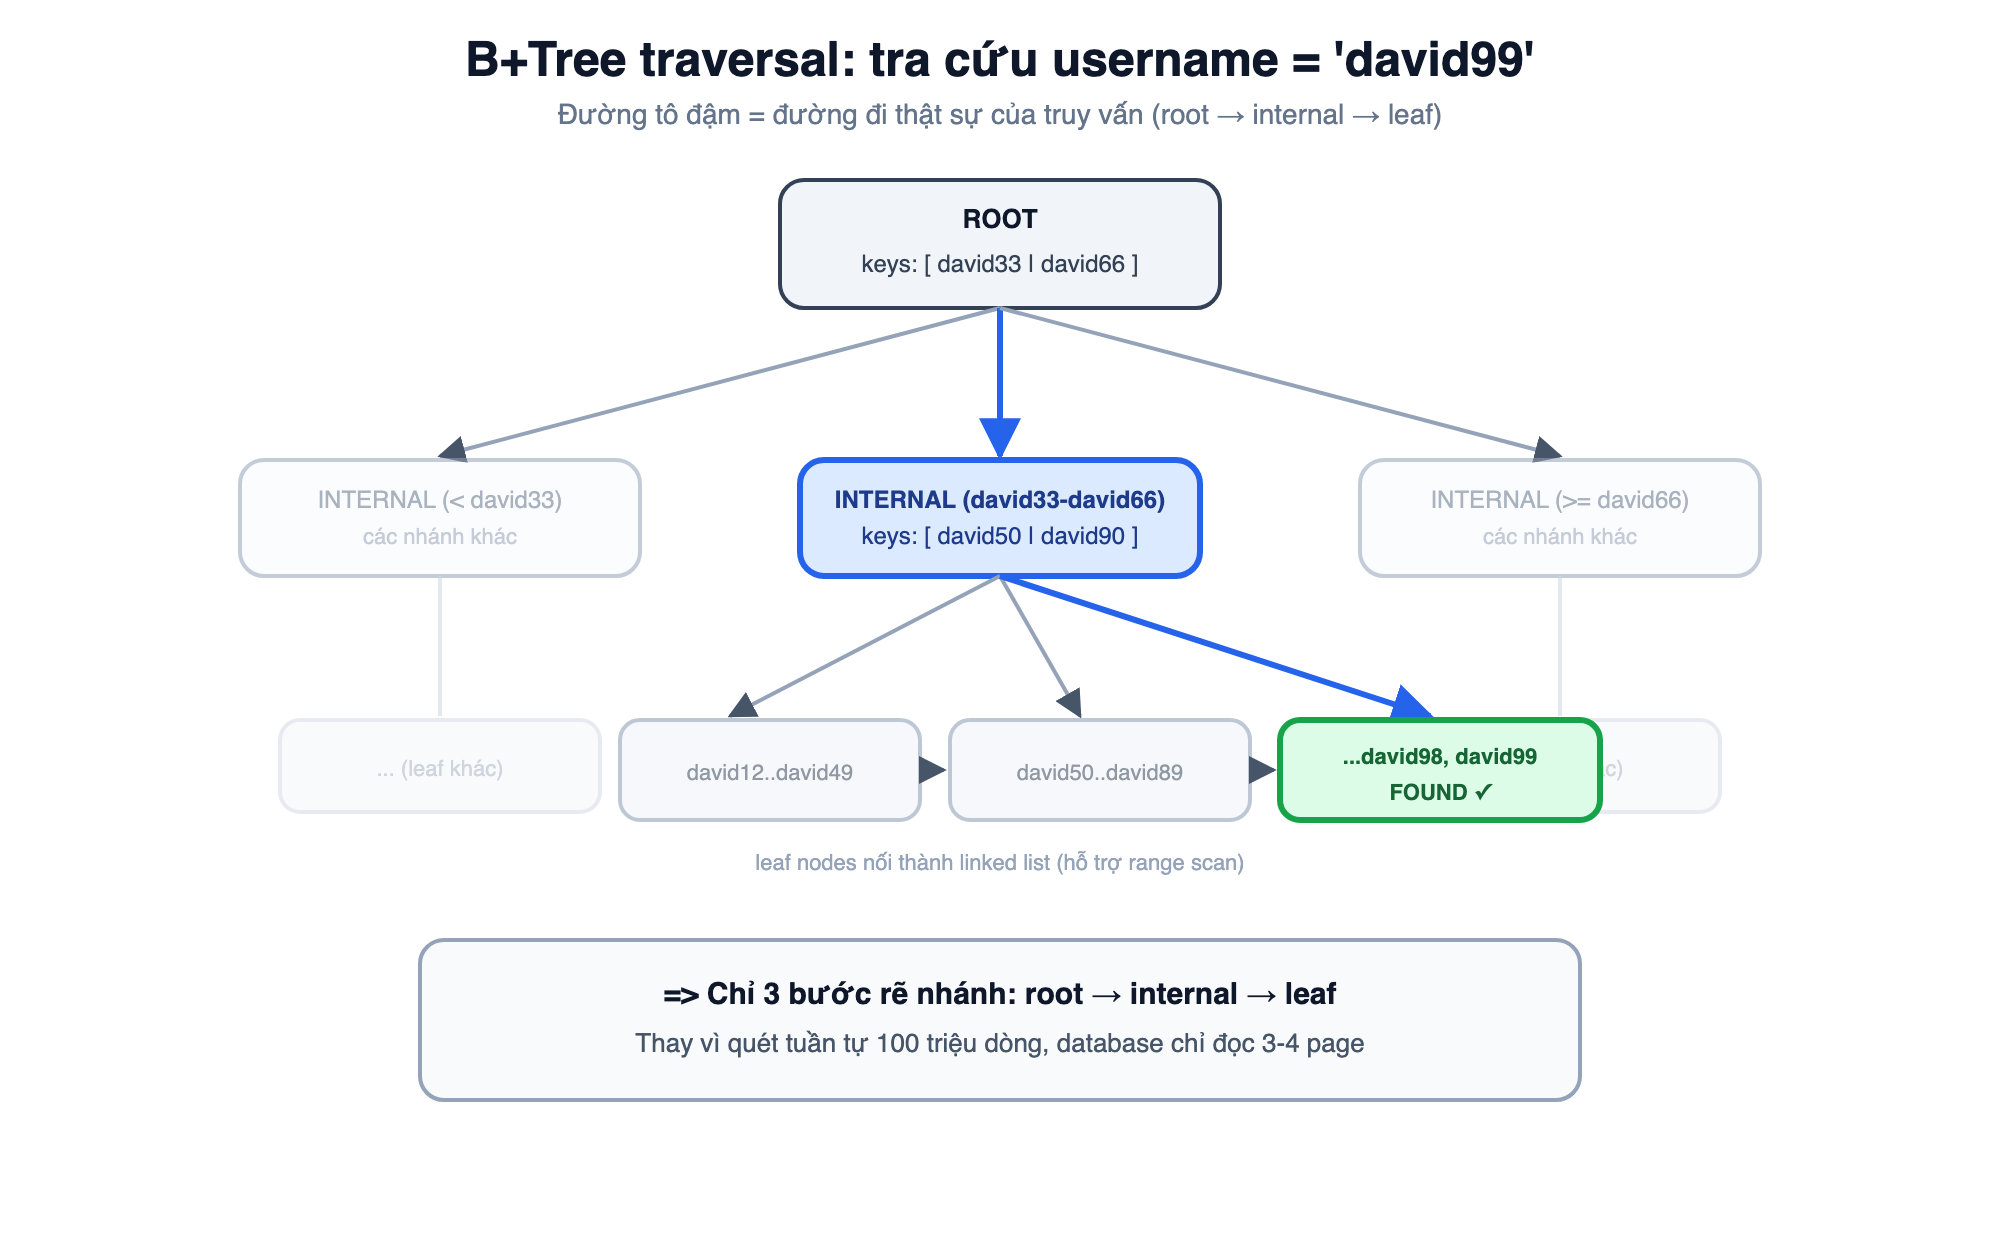
Tra cứu username = "david99" chỉ cần 3-4 lần "rẽ nhánh" từ root xuống leaf, bất kể bảng có 1 triệu hay 100 triệu dòng
=> Kết luận 2: UNIQUE constraint nhanh không phải vì "database tự nhiên biết", mà vì index đứng sau nó là một B+Tree - cấu trúc cây cân bằng, fan-out cao, biến một lookup từ "quét toàn bộ" thành "3-4 lần rẽ nhánh có định hướng"; và chính cơ chế traversal đó cũng được tái sử dụng để kiểm tra trùng lặp ngay trong đường đi của INSERT.
=> Vậy là xong chưa? Có UNIQUE constraint rồi, cứ thế mà dùng thôi?
Đây chính là chỗ nhiều bài viết/tutorial khác dừng lại, nhưng theo mình đó mới chỉ là nửa câu chuyện. Phần tiếp theo mới là phần "đau đầu" thật sự khi hệ thống có traffic lớn.
4. - UNIQUE constraint đã đủ chưa? Câu chuyện ở quy mô cực lớn
4.1 - Check-then-insert vẫn "race", dù có UNIQUE constraint
Nhiều anh em sau khi thêm UNIQUE constraint vẫn giữ nguyên logic cũ ở tầng application - vẫn SELECT trước để trả lỗi thân thiện cho user ("username đã tồn tại"), rồi mới INSERT:
// Vẫn còn race condition, dù DB đã có UNIQUE constraint
public User registerStillRacy(String username, String rawPassword) {
    if (userRepository.findByUsername(username) != null) {
        throw new UsernameAlreadyTakenException(username);
    }
    return userRepository.save(buildUser(username, rawPassword));
}
Timeline y hệt phần 2.2 vẫn xảy ra: hai request cùng pass bước SELECT, cùng chạy tới INSERT. Điểm khác biệt duy nhất là lần này, request thứ hai sẽ bị database từ chối vì vi phạm UNIQUE constraint, thay vì chèn thành công như trước.
=> UNIQUE constraint đã cứu mình khỏi việc data bị hỏng (không còn 2 dòng david99 nữa), nhưng cái giá phải trả là request thứ hai giờ văng ra một exception ở tầng thấp - kiểu DataIntegrityViolationException hoặc thậm chí lộ luôn SQLException gốc - thay vì một lỗi validation sạch sẽ. Dưới tải đăng ký cao, anh em sẽ thấy cả một loạt exception này bắn ra trong log, và nếu không xử lý, user sẽ nhận về một trang lỗi 500 xấu xí thay vì thông báo "username đã được sử dụng".
Nói cách khác: constraint bảo vệ dữ liệu, nhưng không tự động bảo vệ trải nghiệm người dùng. Muốn cả hai, mình phải đổi cách tiếp cận.
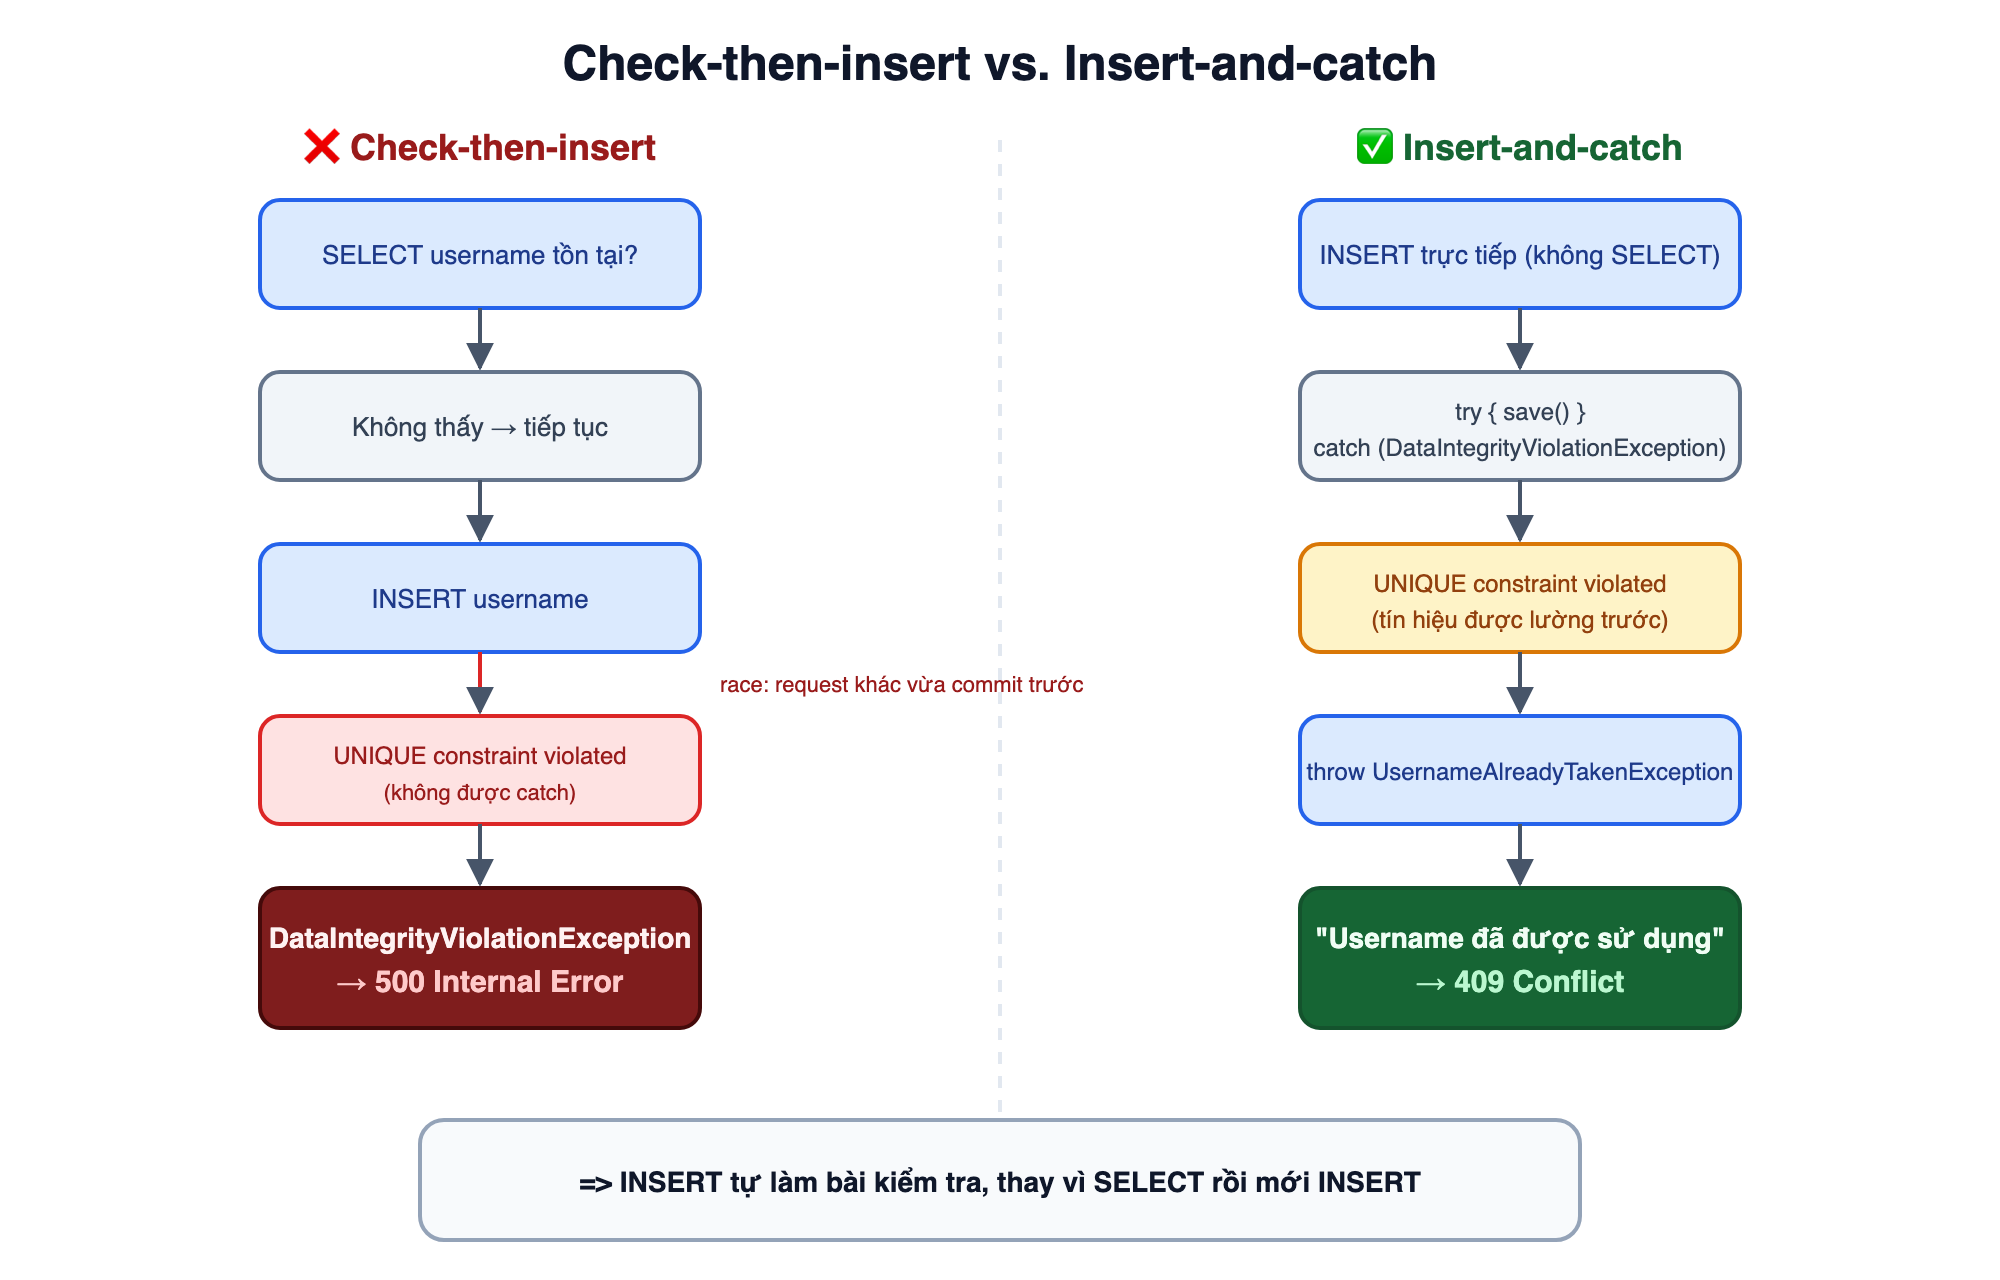
So sánh trước/sau: check-then-insert vẫn để lộ exception thô và response 500, còn insert-and-catch biến chính UNIQUE constraint thành bài kiểm tra và trả về 409 Conflict sạch sẽ
4.2 - Insert-and-catch: để INSERT tự làm bài kiểm tra
Thay vì coi SELECT là bước kiểm tra chính rồi INSERT là bước "chắc chắn sẽ thành công", mình đảo ngược tư duy: INSERT chính là bài kiểm tra. Nếu INSERT thành công, username chưa từng tồn tại. Nếu nó ném ra lỗi vi phạm UNIQUE constraint, đó là tín hiệu "đã bị lấy rồi" - một tín hiệu được lường trước, không phải một lỗi bất ngờ.
@Service
@RequiredArgsConstructor
public class UserService {

    private final UserRepository userRepository;
    private final PasswordEncoder passwordEncoder;

    @Transactional
    public User register(String username, String rawPassword) {
        User user = new User();
        user.setUsername(username);
        user.setPasswordHash(passwordEncoder.encode(rawPassword));
        user.setCreatedAt(Instant.now());

        try {
            return userRepository.save(user);
        } catch (DataIntegrityViolationException ex) {
            // UNIQUE constraint trên `username` chính là trọng tài cuối cùng ở đây
            throw new UsernameAlreadyTakenException(username, ex);
        }
    }
}
public class UsernameAlreadyTakenException extends RuntimeException {

    private final String username;

    public UsernameAlreadyTakenException(String username, Throwable cause) {
        super("Username '" + username + "' đã tồn tại", cause);
        this.username = username;
    }

    public String getUsername() {
        return username;
    }
}
@RestControllerAdvice
public class GlobalExceptionHandler {

    @ExceptionHandler(UsernameAlreadyTakenException.class)
    public ResponseEntity<ApiErrorDto> handleUsernameTaken(UsernameAlreadyTakenException ex) {
        ApiErrorDto body = ApiErrorDto.builder()
                .status(HttpStatus.CONFLICT.value())
                .message("Username đã được sử dụng, vui lòng chọn username khác.")
                .build();
        return ResponseEntity.status(HttpStatus.CONFLICT).body(body);
    }
}
Note: DataIntegrityViolationException là exception chung của Spring khi vi phạm ràng buộc dữ liệu (unique, foreign key, not null...). Nếu muốn phân biệt chính xác đây là do username chứ không phải constraint khác, anh em có thể unwrap ex.getCause() để lấy ConstraintViolationException của driver (Hibernate/JDBC) và check tên constraint (uk_users_username).
Nếu anh em vẫn muốn giữ một bước SELECT trước để trả UX nhanh hơn (kiểu check khi user gõ xong username, trước khi bấm submit) thì hoàn toàn được - nhưng phải hiểu rõ đó chỉ là gợi ý cho UX, còn INSERT (kèm try/catch) mới là nơi đảm bảo tính đúng đắn thật sự. Đừng bao giờ tin tưởng vào kết quả của SELECT đó như một sự đảm bảo.
=> Kết luận 3: Pattern đúng ở tầng application không phải là "check rồi mới act", mà là "act rồi diễn giải kết quả" (act-then-interpret) - để database quyết định, application chỉ việc dịch kết quả đó thành response phù hợp.
4.3 - Fast-path với Redis SETNX: giảm tải cho DB ở traffic cực lớn
Insert-and-catch đã giải quyết được cả tính đúng đắn lẫn UX. Nhưng ở quy mô 100 triệu+ user với hàng nghìn signup/giây, mỗi request vẫn phải chạm tới database để có được câu trả lời cuối cùng - kể cả những request chắc chắn sẽ fail (ví dụ nhiều người cùng thử đăng ký một cái tên hot như admin, test, hay tên một người nổi tiếng).
=> Có cách nào để chặn bớt các request "chắc chắn trùng" trước khi chúng kịp chạm vào database không?
Đây là lúc một lớp fast-path reservation đặt trước database phát huy tác dụng, phổ biến nhất là dùng Redis với lệnh SETNX (SET if Not eXists) - một thao tác nguyên tử ở cấp Redis, cực nhanh (in-memory) và có thể chịu tải hàng trăm nghìn ops/giây dễ dàng.
public class UsernameReservationService {

    private static final int RESERVATION_TTL_SECONDS = 30;

    private final JedisPool jedisPool;

    public UsernameReservationService(JedisPool jedisPool) {
        this.jedisPool = jedisPool;
    }

    /**
     * Thử "giữ chỗ" username trong 30s - đủ thời gian để hoàn tất INSERT xuống DB.
     * Trả về true nếu giữ chỗ thành công (username có vẻ như đang trống).
     */
    public boolean tryReserve(String username) {
        try (Jedis jedis = jedisPool.getResource()) {
            String key = "username:reserved:" + username;
            String result = jedis.set(
                    key,
                    "reserved",
                    SetParams.setParams().nx().ex(RESERVATION_TTL_SECONDS)
            );
            return "OK".equals(result);
        }
    }

    public void release(String username) {
        try (Jedis jedis = jedisPool.getResource()) {
            jedis.del("username:reserved:" + username);
        }
    }
}
@Service
@RequiredArgsConstructor
public class UserService {

    private final UserRepository userRepository;
    private final UsernameReservationService reservationService;
    private final PasswordEncoder passwordEncoder;

    @Transactional
    public User register(String username, String rawPassword) {
        if (!reservationService.tryReserve(username)) {
            // Chặn ở Redis, không cần chạm DB cho case này
            throw new UsernameAlreadyTakenException(username, null);
        }

        try {
            return userRepository.save(buildUser(username, rawPassword, passwordEncoder));
        } catch (DataIntegrityViolationException ex) {
            throw new UsernameAlreadyTakenException(username, ex);
        } finally {
            reservationService.release(username);
        }
    }
}
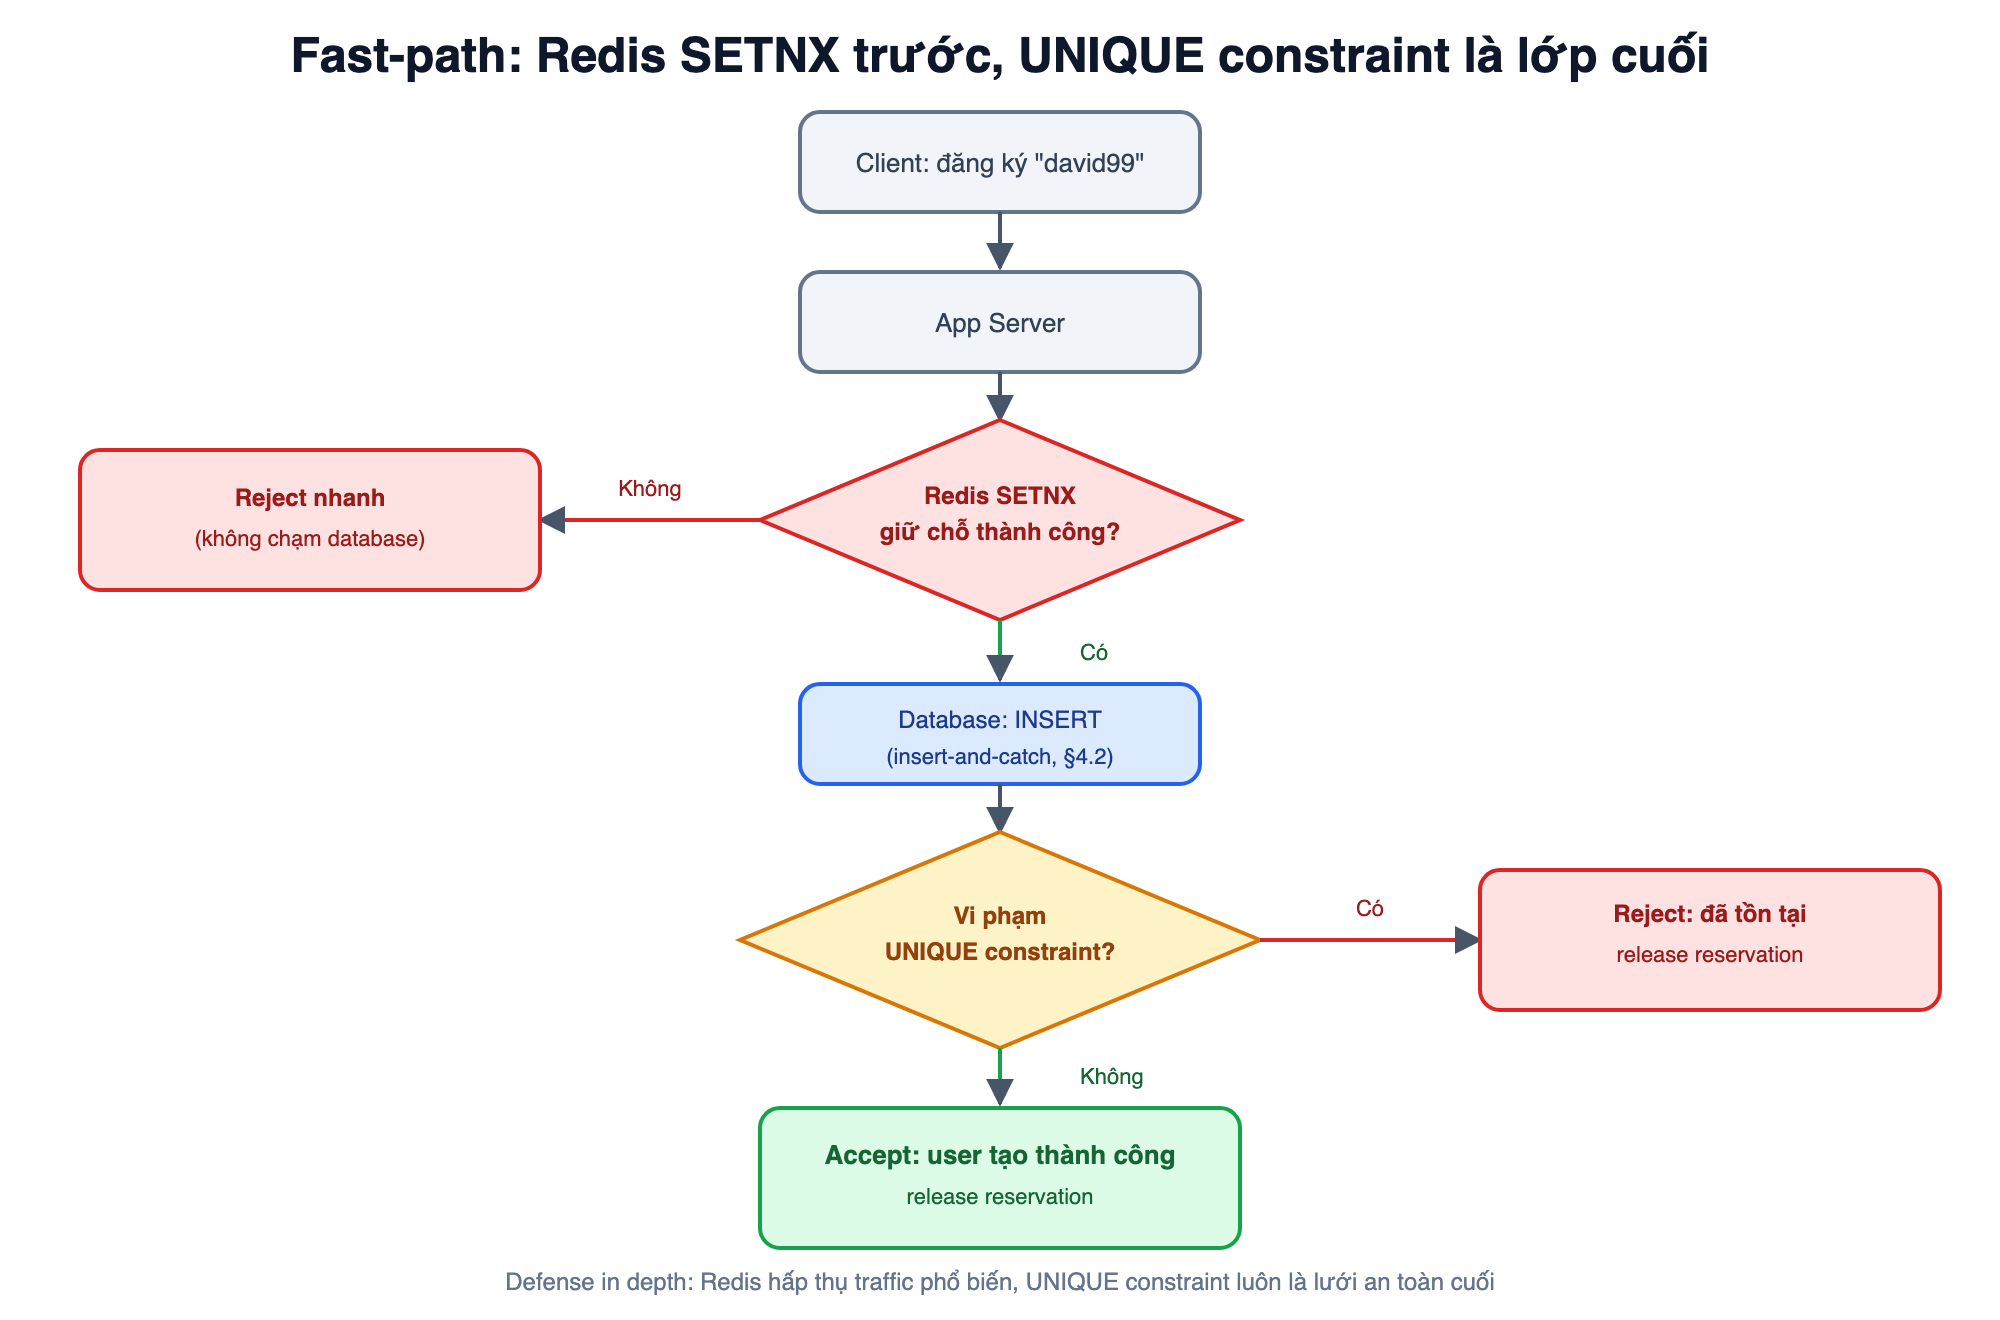
Redis SETNX làm fast-path reservation, UNIQUE constraint ở DB vẫn là lớp phòng thủ cuối cùng (defense in depth)
Lưu ý mấu chốt: UNIQUE constraint ở database vẫn phải giữ nguyên, không được bỏ đi. Redis mang lại độ trễ thấp và giảm tải rất nhiều cho database ở nhánh phổ biến, nhưng nó không thể thay thế vai trò "nguồn chân lý" của database, vì:
- Cache có thể bị evict, Redis node có thể restart mất dữ liệu (nếu không cấu hình persistence phù hợp).
- Reservation có TTL - nếu flow đăng ký bị treo/crash giữa chừng, reservation tự hết hạn, để lại một khoảng hở nhỏ về lý thuyết.
- Trong hệ thống nhiều Redis cluster/region, dữ liệu có thể chưa kịp đồng bộ.
=> Đây chính là tư duy defense in depth: Redis xử lý phần lớn traffic ở tốc độ cao, còn UNIQUE constraint ở DB đóng vai trò lưới an toàn cuối cùng, đảm bảo dù Redis có sai sót gì thì dữ liệu vẫn không bao giờ bị hỏng.
4.4 - Sharded database: UNIQUE constraint theo shard vẫn chưa đủ
Ở quy mô 100 triệu+ dòng, rất có thể bảng users của anh em đã được sharded ra nhiều database instance để scale việc ghi (thường shard theo user_id hoặc hash(user_id)).
Câu hỏi đặt ra: UNIQUE constraint trên username ở từng shard có đảm bảo username là duy nhất trên toàn hệ thống không?
=> Không! Và đây là lý do:
- Mỗi shard là một database instance độc lập, tự enforce
UNIQUEconstraint trong phạm vi dữ liệu của chính nó. - Vì shard key thường là
user_id(để phân bổ đều tải ghi), chứ không phảiusername, nên hai user chọn cùngusernamehoàn toàn có thể bị route tới hai shard khác nhau. - Shard A không hề biết shard B đang có gì, và ngược lại → cả hai đều thấy
usernameđó "chưa tồn tại" trong phạm vi của mình → cả hai đềuINSERTthành công → duplicate xảy ra ở cấp độ toàn hệ thống, dù từng shard riêng lẻ vẫn "đúng" theo constraint của nó.
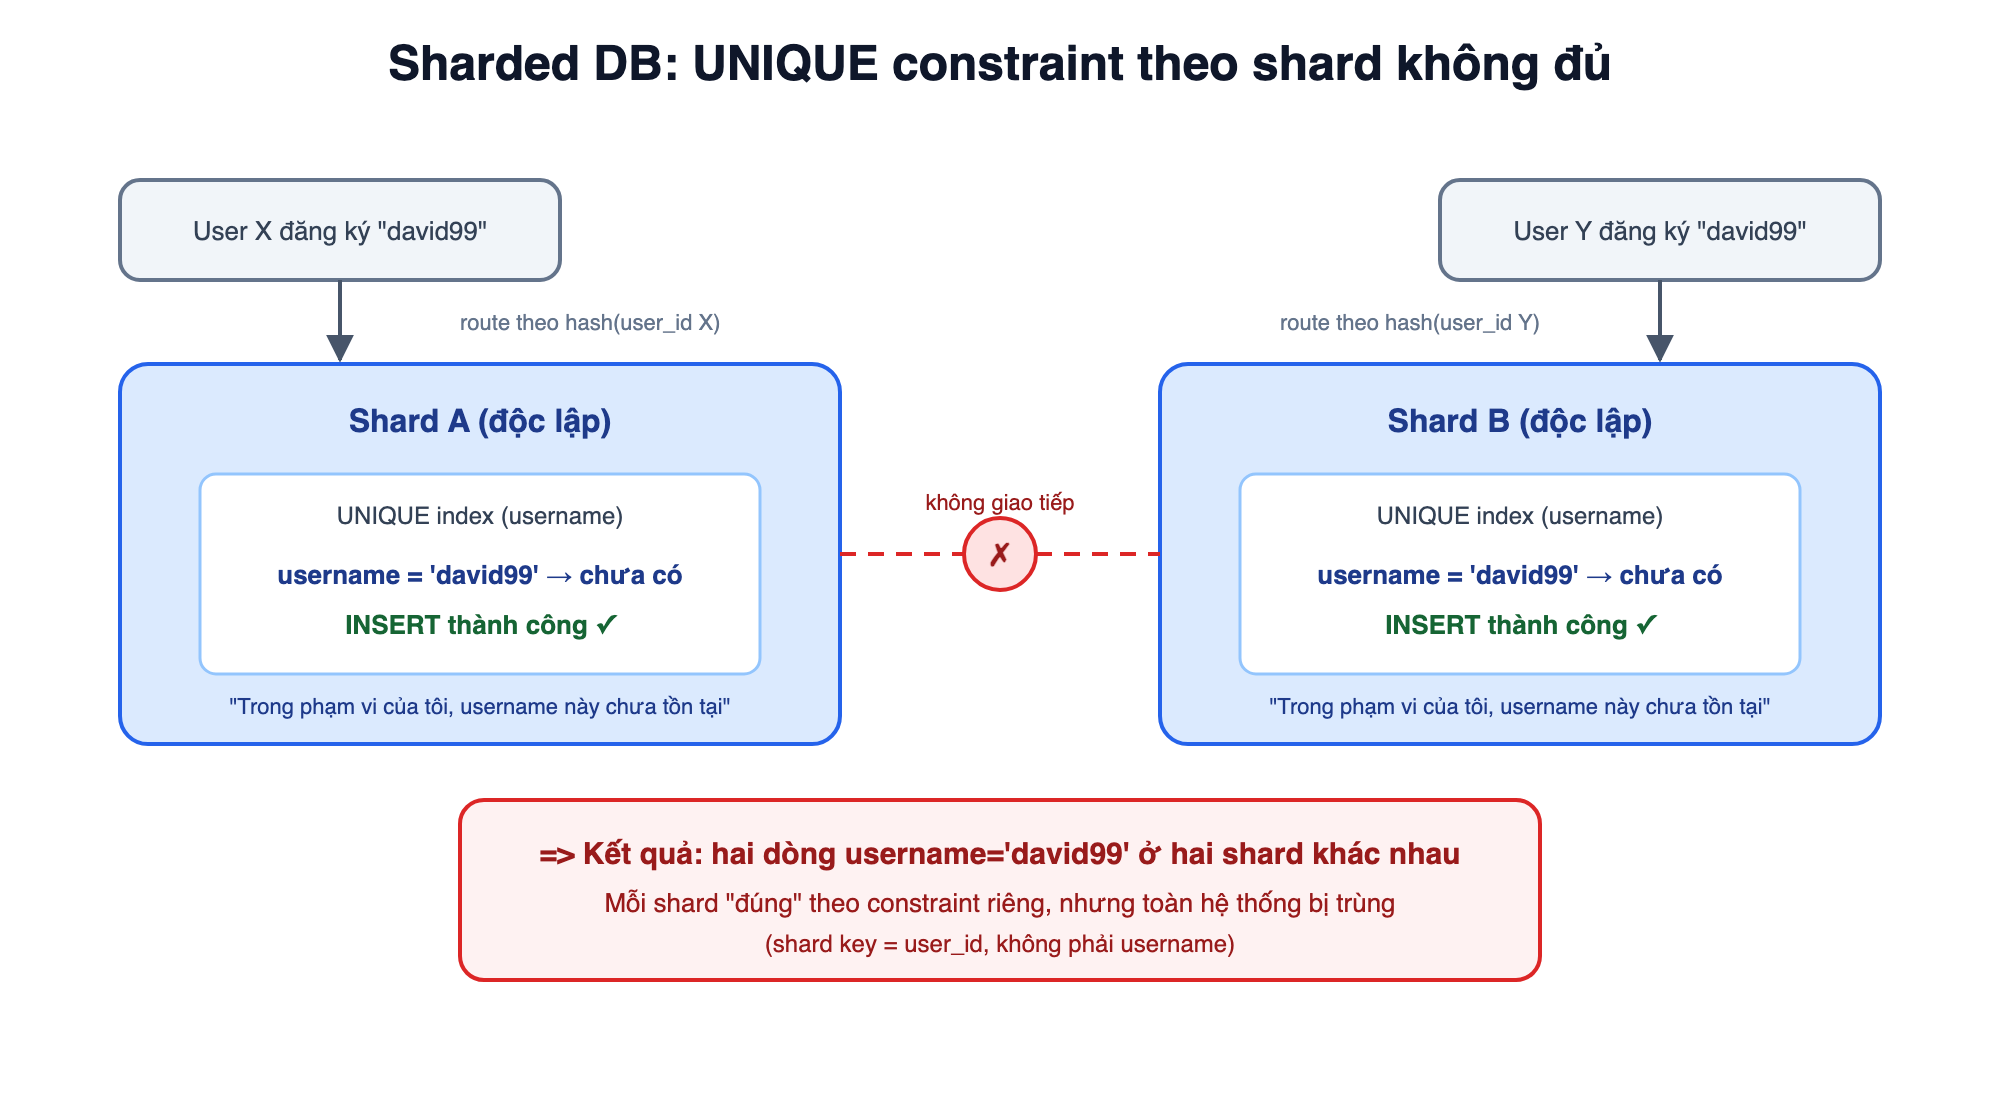
Shard A và Shard B không hề nói chuyện với nhau: cả hai đều thấy "david99" trống trong phạm vi của mình và đều INSERT thành công, tạo ra duplicate ở cấp toàn hệ thống
Cách khắc phục thường thấy:
- Route theo
usernamecho riêng phần kiểm tra định danh: dùnghash(username)để xác định một shard/service phụ trách "sự thật" về username đó, tách biệt với shard key chính (user_id) dùng cho phần data còn lại. - Một bảng/service registry riêng cho username: một bảng nhỏ dạng
username_registry(username, user_id)không sharded (hoặc shard theohash(username)), đóng vai trò single source of truth toàn cục. Flow đăng ký sẽ:INSERTvàousername_registrytrước (đây là bước enforce uniqueness toàn cục) → nếu thành công mới tạo recordUserđầy đủ ở shard tương ứng theouser_id. - Lớp Redis fast-path ở phần 4.3 lúc này càng có giá trị hơn, vì Redis cluster có thể route theo key (
username) trên toàn bộ cluster, không bị giới hạn bởi ranh giới shard của database.
=> Kết luận 4: Trong hệ thống sharded, "duy nhất trong một shard" và "duy nhất toàn cục" là hai khái niệm khác nhau - UNIQUE constraint chỉ đảm bảo vế đầu, còn vế sau cần một cơ chế điều phối toàn cục (routing theo username, hoặc một registry riêng).
4.5 - Bloom filter: trả lời "chắc chắn còn trống" ngay trong bộ nhớ, không cần mạng
Ở phần 4.3, Redis SETNX đã giúp giảm tải rất nhiều cho database. Nhưng dù Redis nhanh cỡ nào, mỗi lần check vẫn tốn ít nhất một network round-trip. Với phần lớn traffic đăng ký - user gõ một cái tên hoàn toàn mới, chưa ai từng dùng - liệu có cách nào trả lời "còn trống" ngay tức khắc, ngay trong tiến trình của chính app instance, không cần đi đâu cả không?
=> Có, đây chính là lúc Bloom filter phát huy tác dụng.
Bloom filter là gì? Về bản chất nó chỉ là một mảng bit (bit array) kích thước m, ban đầu toàn số 0, cùng với k hàm hash độc lập. Chỉ có hai thao tác:
- Thêm một
usernamevào filter: bămusernamequakhàm hash, rakvị trí trong mảng bit, set cảkbit đó thành 1. - Kiểm tra một
usernamecó trong filter không: băm y hệt như trên rakvị trí, rồi kiểm tra xem cảkbit đó có đang là 1 hết không.
Điểm mấu chốt, quyết định toàn bộ giá trị của cấu trúc này, nằm ở tính bất đối xứng trong câu trả lời:
- Nếu có ít nhất một trong
kbit là 0 → username này chắc chắn chưa từng được thêm vào filter (chắc chắn còn trống). Không có ngoại lệ, không có false negative. - Nếu cả
kbit đều là 1 → username này có thể đã tồn tại - nhưng cũng có thể đây chỉ là trùng hợp ngẫu nhiên, khi các bit đó bị set bởi những username khác (hash collision). Đây gọi là false positive, và Bloom filter chấp nhận đánh đổi này để đổi lấy kích thước cực nhỏ gọn.
=> Nói ngắn gọn: Bloom filter không bao giờ nói sai "chưa có", nhưng có thể nói sai "đã có". Chính sự bất đối xứng "no false negative, có thể false positive" này là lý do nó khớp hoàn hảo với bài toán username.
Vì sao? Vì trường hợp phổ biến nhất khi user đăng ký là họ gõ một cái tên thật sự chưa ai dùng. Với case đó, câu trả lời "chưa có" của Bloom filter là một đảm bảo tuyệt đối, không cần xác minh lại - app có thể trả lời "username khả dụng" ngay lập tức, hoàn toàn miễn phí (không network hop, filter nằm sẵn trong RAM của chính app instance), mà không cần chạm tới Redis hay database. Chỉ khi filter trả lời "có thể đã tồn tại" thì request đó mới rơi xuống các bước đắt đỏ hơn đã bàn ở phần trước - reservation ở Redis (4.3), rồi insert-and-catch xuống database (4.2) - để có câu trả lời chính xác tuyệt đối.
@Component
public class UsernameBloomFilter {

    private volatile BloomFilter<String> filter;

    public UsernameBloomFilter(long expectedInsertions) {
        this.filter = createEmpty(expectedInsertions);
    }

    private BloomFilter<String> createEmpty(long expectedInsertions) {
        // fpp (false positive probability) 0.1% là mức chấp nhận được cho use case này
        return BloomFilter.create(Funnels.stringFunnel(StandardCharsets.UTF_8), expectedInsertions, 0.001);
    }

    /** true = có thể đã tồn tại (không chắc chắn); false = chắc chắn CHƯA từng thấy username này */
    public boolean mightContain(String username) {
        return filter.mightContain(username);
    }

    /** Gọi ngay sau khi INSERT username thành công xuống DB */
    public void markAsTaken(String username) {
        filter.put(username);
    }
}
@Service
@RequiredArgsConstructor
public class UsernameAvailabilityService {

    private final UsernameBloomFilter bloomFilter;
    private final UserRepository userRepository;

    /**
     * Dùng cho UX kiểu "gõ tới đâu, báo available tới đó" - KHÔNG phải bước
     * quyết định cuối cùng khi submit form. Insert-and-catch (4.2) vẫn là nơi
     * duy nhất đảm bảo tính đúng đắn thật sự.
     */
    public boolean isProbablyAvailable(String username) {
        if (!bloomFilter.mightContain(username)) {
            // Filter nói "chưa từng thấy" -> tin tuyệt đối, trả lời ngay, miễn phí
            return true;
        }
        // Filter nói "có thể đã tồn tại" -> không tin ngay, rơi xuống bước
        // đắt đỏ hơn (Redis reservation / DB) để xác minh chính xác
        return !userRepository.existsByUsername(username);
    }
}
Đồng bộ filter thế nào?
- Ngay sau khi một
INSERTthành công (bước insert-and-catch ở 4.2), gọibloomFilter.markAsTaken(username)để thêm nó vào filter - từ đó về sau, mọi lần check username này sẽ trả lời đúng. - Bloom filter không hỗ trợ xoá phần tử theo cách thông thường, vì một bit có thể đang được nhiều key khác nhau cùng share (do hash collision) - xoá nhầm một bit có thể khiến những key khác "biến mất" khỏi filter một cách sai lệch. Nếu hệ thống của anh em cho phép username được giải phóng để dùng lại (ví dụ xoá tài khoản, đổi username), cần dùng biến thể counting Bloom filter (mỗi vị trí là một counter thay vì 1 bit, tăng khi add, giảm khi remove) hoặc chấp nhận rebuild định kỳ.
- Ở quy mô 100 triệu+ username, filter cần được rebuild định kỳ (ví dụ một batch job đọc toàn bộ
usernametừ DB và build lại filter mỗi vài giờ) để tránh trôi dần theo thời gian, hoặc dùng một cấu trúc scalable/dùng chung hơn thay vì để mỗi app instance tự giữ một bản in-memory riêng - ví dụ moduleRedisBloom(BF.ADD,BF.EXISTS) chạy ngay trên cùng cụm Redis đã dùng ở 4.3, giúp mọi instance chia sẻ chung một filter thay vì mỗi instance tự lệch pha với nhau.
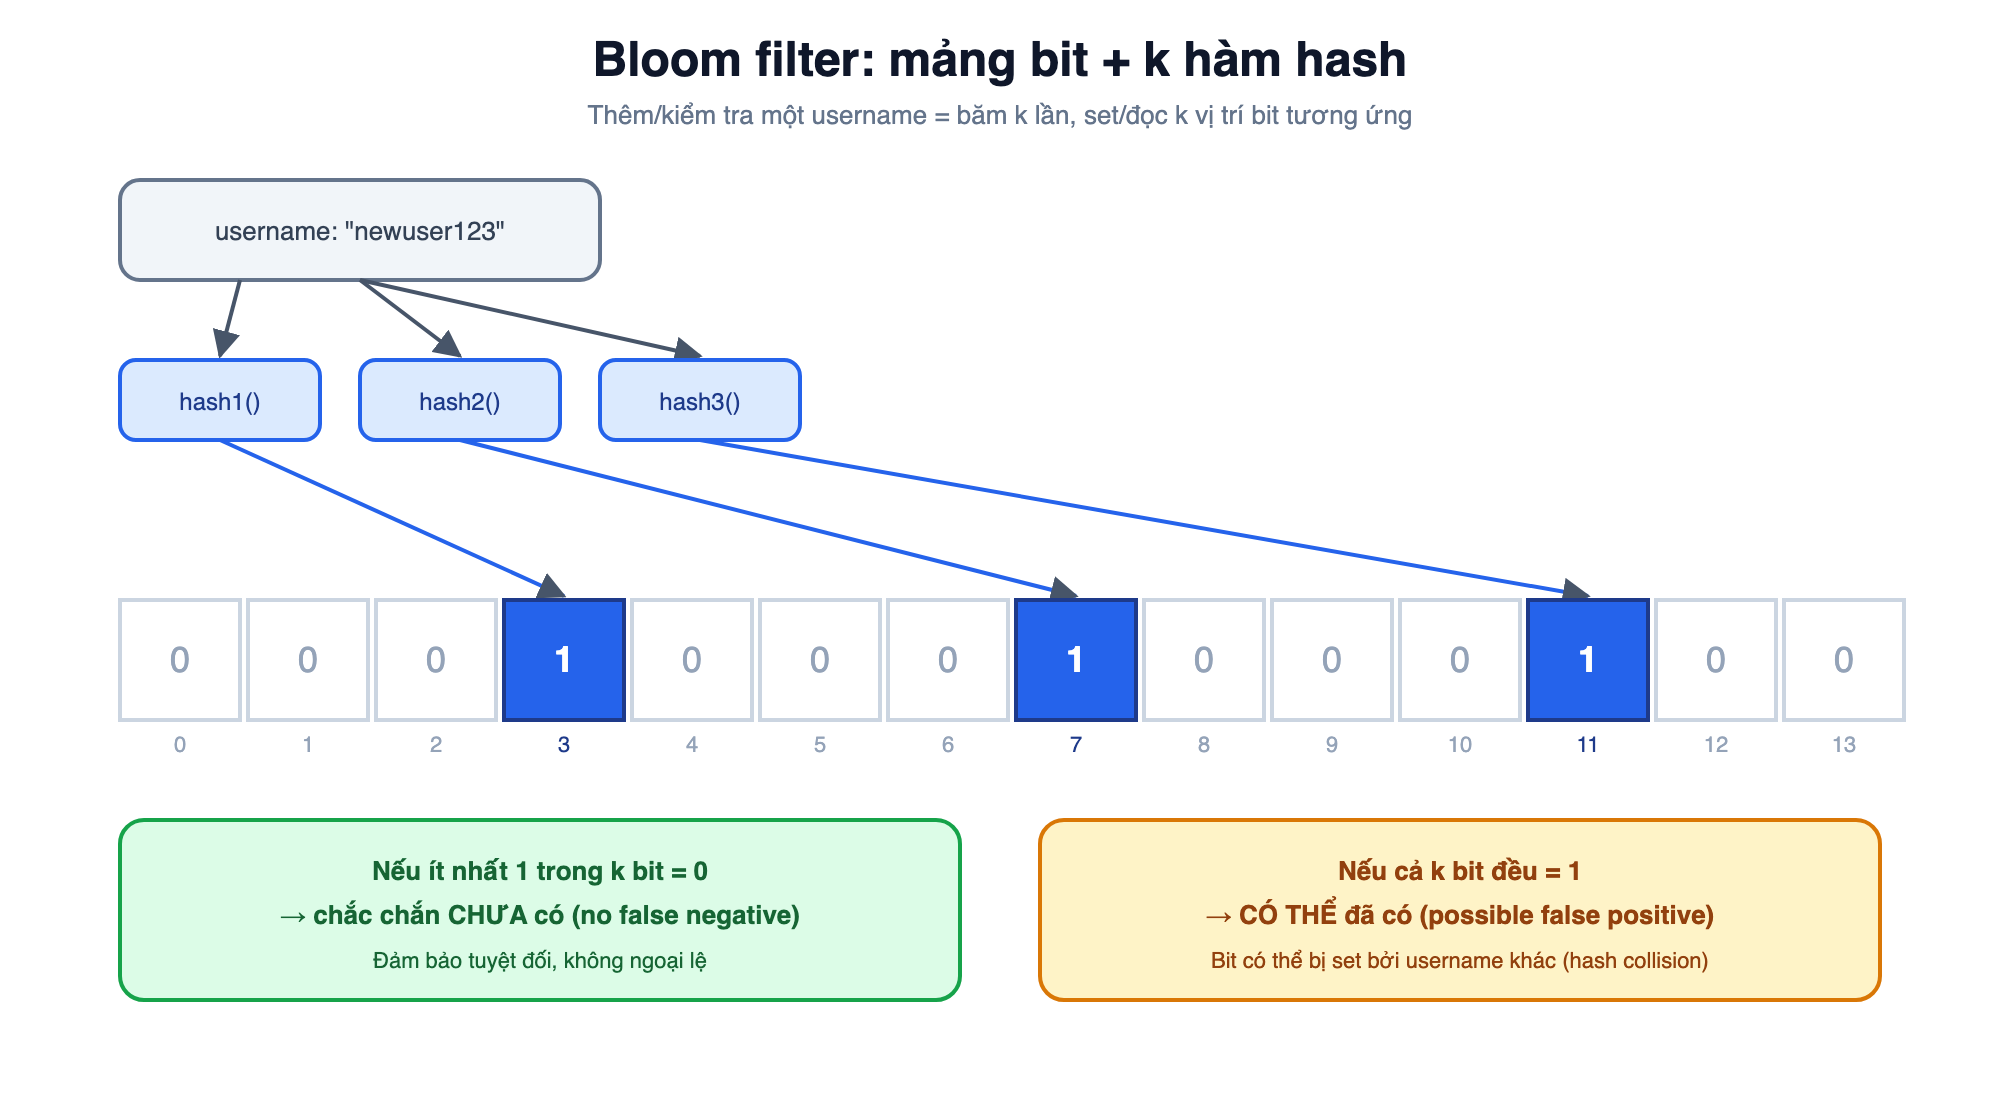
Bloom filter: thêm/kiểm tra một username chỉ là băm k lần rồi set/đọc k bit - không false negative, có thể false positive
4.6 - Ghép lại: Bloom filter cho "chắc chắn trống", cache cho "chắc chắn đã lấy"
Giờ nhìn lại, mình có đúng hai nửa bổ sung cho nhau của cùng một bài toán.
Ở quy mô 100 triệu+ user, một pattern rất phổ biến khác là nhiều người cùng thử một username "hot" (admin, test123, tên một celebrity...) và gần như chắc chắn nó đã bị lấy từ lâu. Đây là trường hợp lý tưởng để dùng read-through cache: lưu tập các username đã biết là bị chiếm, để những lần kiểm tra tiếp theo không cần chạm DB (hoặc Redis reservation) nữa.
Nhưng - y hệt tinh thần ở phần 4.5 - cache này chỉ nên đáng tin cho câu trả lời "đã tồn tại", không nên dùng để khẳng định "chưa tồn tại". Vì sao?
=> Vì nếu cache trả lời sai theo hướng "chưa tồn tại" (false negative) trong khi thực ra username đã được ai đó chiếm ngay trước đó (nhưng cache chưa kịp cập nhật), request tiếp theo sẽ đi thẳng tới bước INSERT mà không có gì đảm bảo an toàn cả - và đây lại chính là lúc mình cần UNIQUE constraint (và/hoặc Redis reservation) làm lớp chốt chặn cuối. Ngược lại, nếu cache trả lời sai theo hướng "đã tồn tại" (false positive, ví dụ do TTL invalidate chậm sau khi một tài khoản bị xoá), cái giá phải trả chỉ là user phải đổi sang tên khác - khó chịu nhưng không gây hỏng dữ liệu.
Đặt hai cấu trúc cạnh nhau, anh em sẽ thấy chúng là hai mặt đối xứng của cùng một đồng xu:
| Cấu trúc | Đáng tin cho câu trả lời | Không đáng tin cho câu trả lời | Vì sao |
|---|---|---|---|
| Bloom filter | "Chắc chắn còn trống" | "Chắc chắn đã bị lấy" | Không có false negative, nhưng có thể false positive |
| Read-through cache (positive-only) | "Chắc chắn đã bị lấy" | "Chắc chắn còn trống" | Cache chỉ lưu kết quả positive đã xác minh, negative rất dễ bị stale |
=> Ghép hai mảnh này lại, thứ tự kiểm tra hợp lý nhất cho một request check-username trở thành:
- Cache "đã lấy" trả lời có → chắc chắn đã bị lấy, trả lời ngay, không cần đi tiếp.
- Bloom filter trả lời "chưa từng thấy" → chắc chắn còn trống, trả lời ngay, không cần đi tiếp.
- Chỉ khi cả hai đều không cho câu trả lời chắc chắn (cache miss, Bloom filter nói "có thể đã tồn tại") → đây mới là vùng thật sự mơ hồ, cần rơi xuống các bước đắt đỏ và authoritative hơn: Redis reservation (4.3) hoặc insert-and-catch xuống database (4.2).
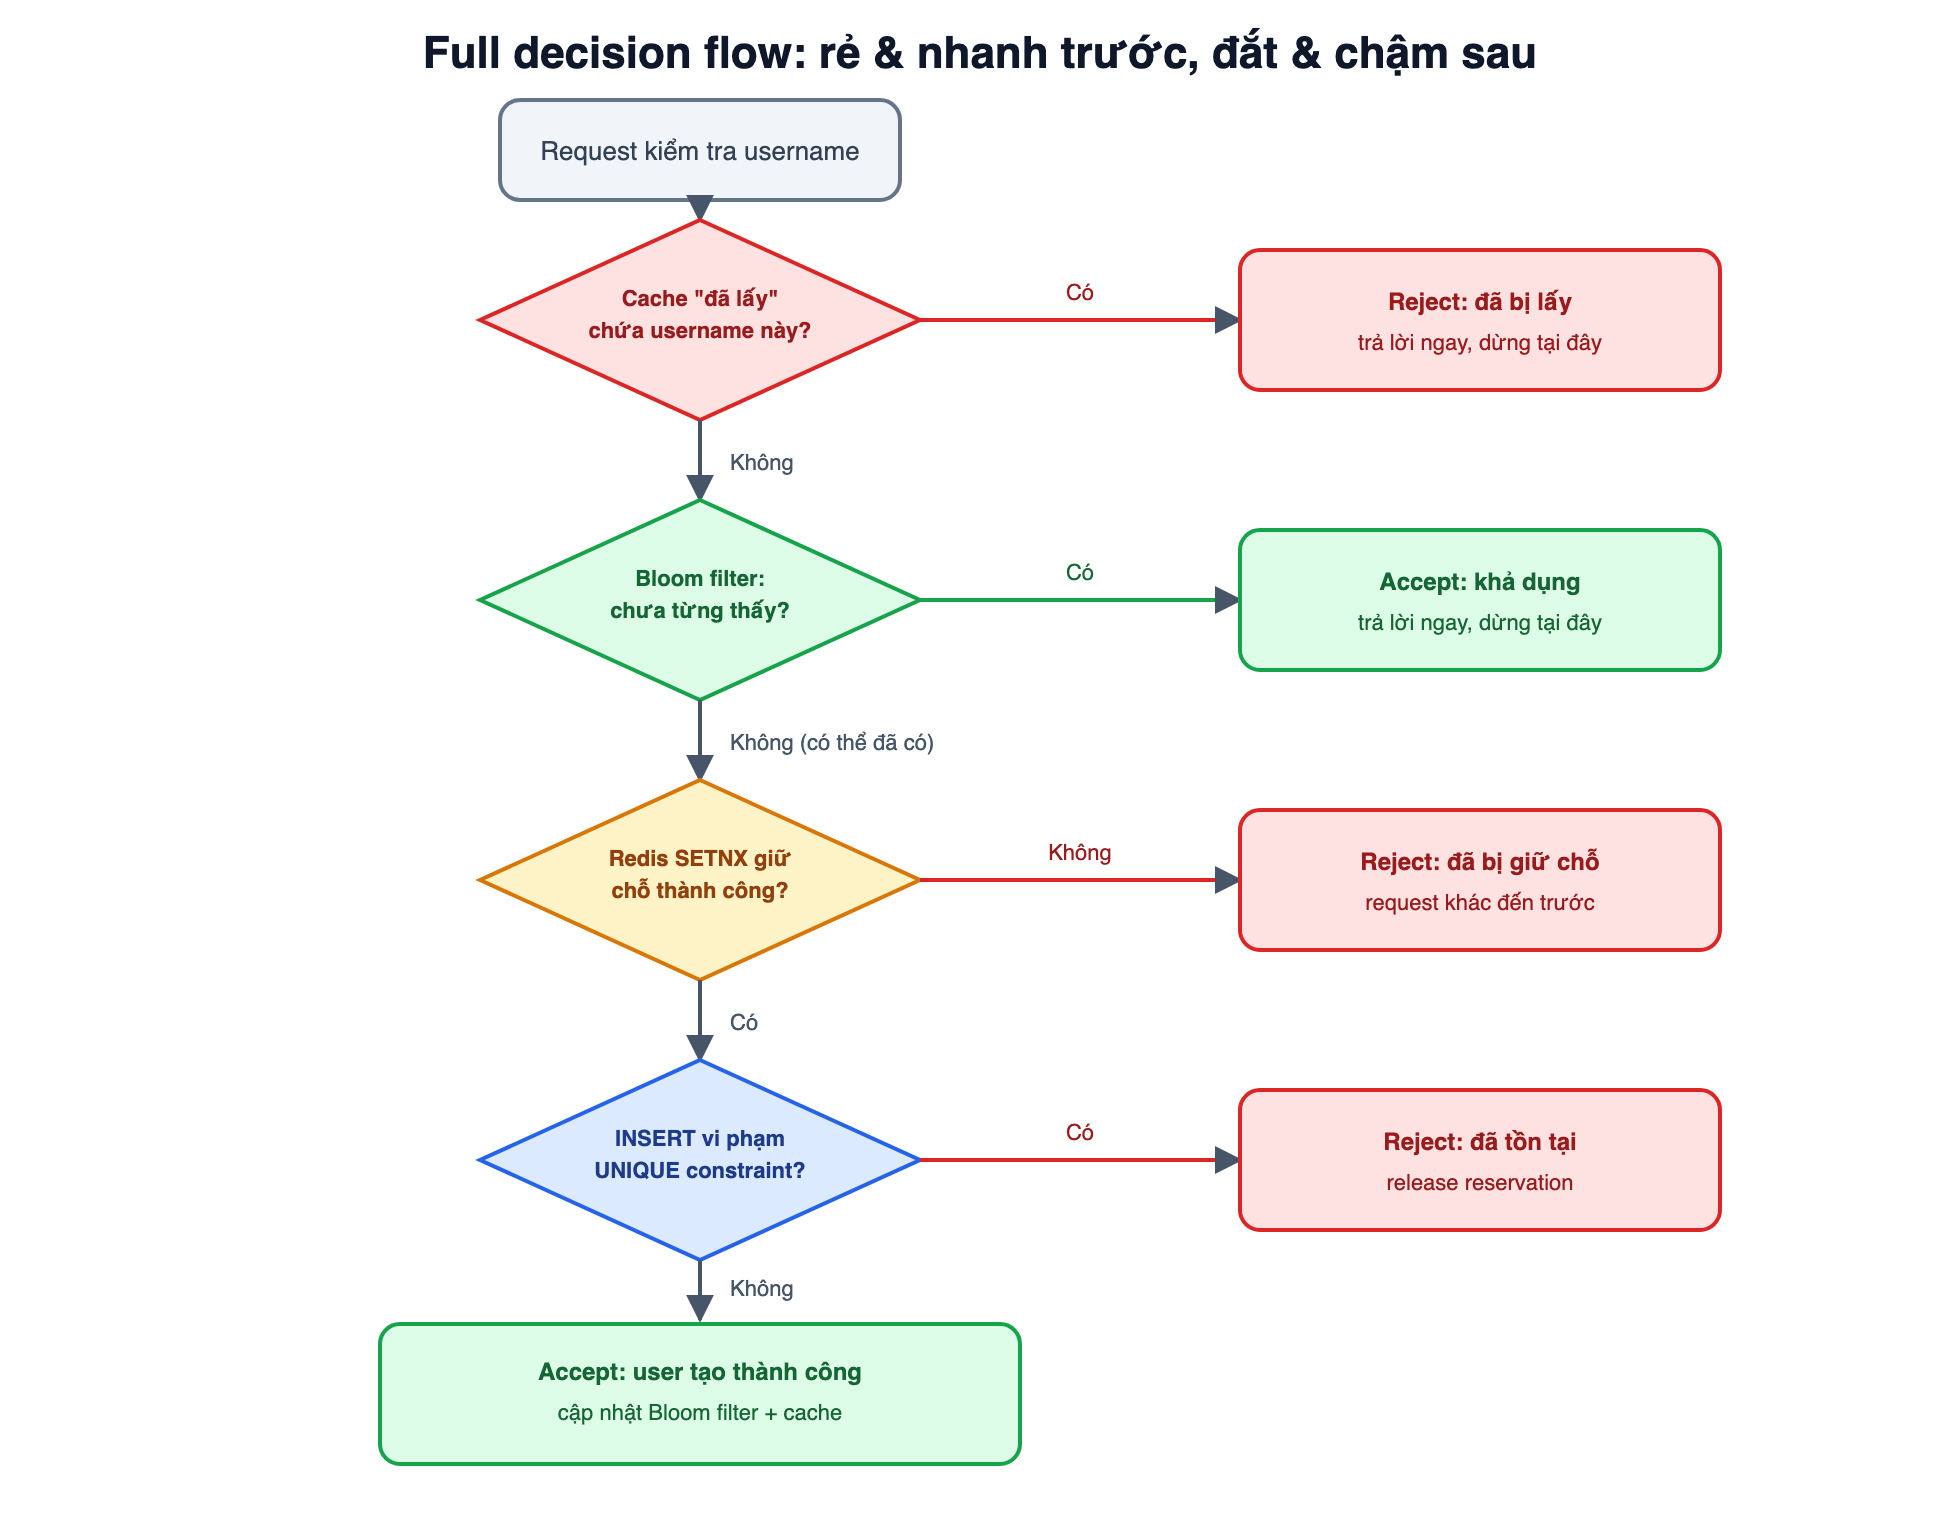
Một request đăng ký đi qua đúng bốn lớp phòng thủ theo thứ tự từ rẻ/nhanh đến đắt/chậm: cache "đã lấy" → Bloom filter "chưa từng thấy" → Redis reservation → insert-and-catch với UNIQUE constraint ở database
Nói cách khác, hai cấu trúc "miễn phí" này (in-memory, không network hop) hấp thụ gần như toàn bộ traffic ở hai đầu phân phối - phần lớn request rơi vào một trong hai nhóm "chắc chắn trống" hoặc "chắc chắn đã lấy" - chỉ để lại một phần nhỏ thật sự cần tới Redis/DB.
=> Kết luận 5: Bloom filter và read-through cache là hai nửa bổ sung cho nhau, không cạnh tranh nhau: Bloom filter trả lời chắc chắn cho nhánh "còn trống", cache trả lời chắc chắn cho nhánh "đã bị lấy" - phần còn lại, thật sự mơ hồ, mới cần đụng tới Redis reservation và UNIQUE constraint ở database.
5. - So sánh tổng quan các cách tiếp cận
| Cách tiếp cận | Đúng đắn dưới concurrency | Hiệu năng ở 100M+ rows | UX lỗi rõ ràng | Chịu được traffic đăng ký cực lớn |
|---|---|---|---|---|
SELECT rồi INSERT, không index | ❌ | ❌ | ✅ | ❌ |
UNIQUE constraint, nhưng app vẫn SELECT trước | ✅ (data không hỏng) | ✅ | ❌ (lỗi DB thô) | ❌ |
Insert-and-catch + UNIQUE constraint | ✅ | ✅ | ✅ | ⚠️ (DB nhận toàn bộ traffic) |
Redis SETNX fast-path + UNIQUE constraint | ✅ | ✅ | ✅ | ✅ |
| + Registry/routing riêng cho sharded DB | ✅ (kể cả toàn cục) | ✅ | ✅ | ✅ |
| + Bloom filter & cache pre-check trước Redis/DB | ✅ (kế thừa từ tầng dưới) | ✅ | ✅ | ✅ 🚀 (giảm tải nhiều nhất cho nhánh phổ biến) |
Note: Bloom filter và cache pre-check không tự thêm correctness guarantee mới - chúng chỉ hấp thụ phần lớn traffic ở hai đầu "chắc chắn trống"/"chắc chắn đã lấy" (miễn phí, in-memory), giúp giảm tải đáng kể cho Redis và database ở nhánh còn lại. Tính đúng đắn thật sự vẫn do UNIQUE constraint (kèm reservation/registry phía trên) đảm bảo.
6. - Kết luận & tổng kết
Quay lại câu hỏi đầu bài: chống duplicate username thì khó đến mức nào?
Câu trả lời tuỳ vào quy mô hệ thống của anh em, và bài viết này đi qua đúng hành trình đó:
SELECTtrước khiINSERT, không index → dễ viết nhất, nhưng vừa chậm (full table scan) vừa sai (check-then-act race condition).UNIQUEconstraint/index ở tầng database → giải quyết cả hiệu năng lẫn correctness cơ bản, biến database thành nguồn chân lý duy nhất.- B+Tree đứng sau index → lý do index seek chỉ tốn 3-4 page read bất kể bảng có 1 triệu hay 100 triệu dòng, và cùng cơ chế traversal đó cũng khiến việc enforce
UNIQUEconstraint ngay trong đường điINSERTtrở nên nhanh, chứ không chỉ riêngSELECTmới hưởng lợi. - Insert-and-catch → nếu vẫn giữ thói quen
SELECTtrước ở tầng app thì race condition vẫn còn đó (dù không còn phá hỏng data); cách đúng là đểINSERTtự làm bài kiểm tra và bắt lỗi constraint như một tín hiệu được lường trước. - Redis
SETNXfast-path + sharding-aware global uniqueness → ở traffic cực lớn và dữ liệu được sharded, cần thêm một lớp điều phối toàn cục (Redis reservation, registry riêng, hoặc routing theo username) đứng trước database để vừa giảm tải vừa đảm bảo tính duy nhất toàn cục, chứ không chỉ trong phạm vi một shard. - Bloom filter + read-through cache → hai cấu trúc in-memory, miễn phí, bổ sung cho nhau: Bloom filter trả lời chắc chắn cho nhánh "còn trống", cache trả lời chắc chắn cho nhánh "đã bị lấy" - chỉ phần mơ hồ ở giữa mới thật sự cần chạm tới Redis/DB.
Bài học chung, không chỉ áp dụng riêng cho bài toán username: hãy đẩy các đảm bảo về tính đúng đắn (correctness guarantee) xuống tầng dữ liệu, nơi có thể enforce nó một cách nguyên tử và không thể lách qua được. Tầng application (và các lớp cache/fast-path phía trước nó) nên được dùng để phản hồi nhanh và giảm tải (load-shedding), chứ không phải để đóng vai trò "nguồn chân lý" - vì bất cứ logic "check rồi mới act" nào ở tầng application, dù được viết cẩn thận đến đâu, đều có thể bị race condition qua mặt khi tải đủ lớn.
Hẹn gặp lại anh em ở bài viết tiếp theo, cùng nhau mổ xẻ thêm những bài toán scale khác - Happy Coding! 🚀